コンテンツへスキップ

AIゲートウェイ

すでに使っているAIプロバイダーの前に置く1つのゲートウェイ。アカウントも料金もお客様のもの。モデル支出への上乗せは0%です。

14日目より前にキャンセルすれば支払いは不要です。

  • ルーティングルールがリクエストごとにモデルを選びます。
  • フェイルオーバー1つが失敗すると、別のプロバイダーが引き継ぎます。
  • 予算支出上限は呼び出しのたびに事前に確認。

お使いのプロバイダーを、1つのゲートウェイ経由でルーティング

OpenAIAnthropicGoogle AI (Gemini)Azure OpenAIAWS BedrockGoogle Vertex AIxAIMistralCohereGroqTogether AIFireworks AIDeepSeekOpenRouterRunwayTypeSafeCloudflare Workers AIInceptionLiquid AIUpstageMoonshot AI (Kimi)Z.ai (GLM)MiniMaxAlibaba Cloud Model StudioCerebrasPerplexityElevenLabsfal.aiReplicate

AI APIを運営していますか?Provider Programに参加

ルーティング

リクエストの流れが重なったガラスのコントロールプレーンに入り、5つのプロバイダーのエンドポイントへ別々の経路で出ていく様子。

すでにお持ちのプロバイダーアカウントを接続します。アプリは1つのAPIを呼び出し、各リクエストはお客様の認証情報で実行され、プロバイダーから請求されます。

ルートの仕組み 対応プロバイダー

製品

リクエストの確認、フォールバックのテスト、プロバイダーの接続、予算の設定を、この場で。

リクエスト

4件のリクエスト · 直近15分

時間プロジェクトプロバイダーステータスレイテンシー推定費用
処理済み
4中3
フォールバックで復旧
1
プロバイダーの前で拒否
1
推定プロバイダー費用
$0.0100

リクエストを選ぶと、すべての試行、そのレイテンシーと推定費用が表示されます。

開発者

OpenAIクライアントはそのまま。3行を変えるか、コーディングエージェントに任せてください。

APIキー
INFROゲートウェイキー。プロバイダーの認証情報はINFROの中に封印されたままです。
ベースURL
https://api.infro.io/v1
モデル
vendor/modelのID、または設定したルート。

レスポンスはOpenAIの形式のままです。INFRO自身の拒否には専用のエラーコードがあります。

app.py+3−2
import osfrom openai import OpenAI client = OpenAI(削除:    api_key=os.environ["OPENAI_API_KEY"],追加:    api_key=os.environ["INFRO_API_KEY"],追加:    base_url="https://api.infro.io/v1",) response = client.chat.completions.create(削除:    model="gpt-5.6-terra",追加:    model="openai/gpt-5.6-terra",    messages=messages,)

/manage/v1で、プロジェクト、キー、ルート、予算をコードとして設定できます。 管理API

プラットフォーム

すべての機能は、接続したプロバイダーアカウント上で動作します。

ルールがリクエストの行き先を決め、障害時ルールがその後の動作を決めます。

ルートに条件ルールを追加し、障害の種類ごとの動作を選びます。

  • リクエストで条件を判定。 メタデータ、機能、ユーザー、キー、プロンプトのサイズ、ツール、時間帯。
  • 再試行、フェイルオーバー、または停止。 障害ごとに選択:レート制限、サーバーエラー、タイムアウト、接続、認証情報。
  • プロバイダーごとに複数のキー。 アクティブなキーがトラフィックを分担し、スタンバイキーが引き継ぎます。

フェイルオーバーはレスポンスが始まる前に適用されます。中断したストリームは再開されません。

feature support-triageを持つリクエストが、supportという名前のルートに届きます。最初のルールlong-promptsは、入力トークンが32,000を超えると推定されるプロンプトをVertex AIの接続に送るもので、一致しません。2つ目のsupport-triageが一致し、リクエストをAnthropicの接続、次にAWS Bedrockの接続へ送ります。Anthropicが429を返し、ルートのrate_limitに対する障害時ルールがフェイルオーバーを指定しているため、Bedrockの接続が処理します。レスポンスには、ルート、チェーン上の位置standby_a、プロバイダーが示されます。

すでに支払っているプロバイダーで、画像、動画、音声を。最初のプロンプトから、編集ソフトで開くカットまで。

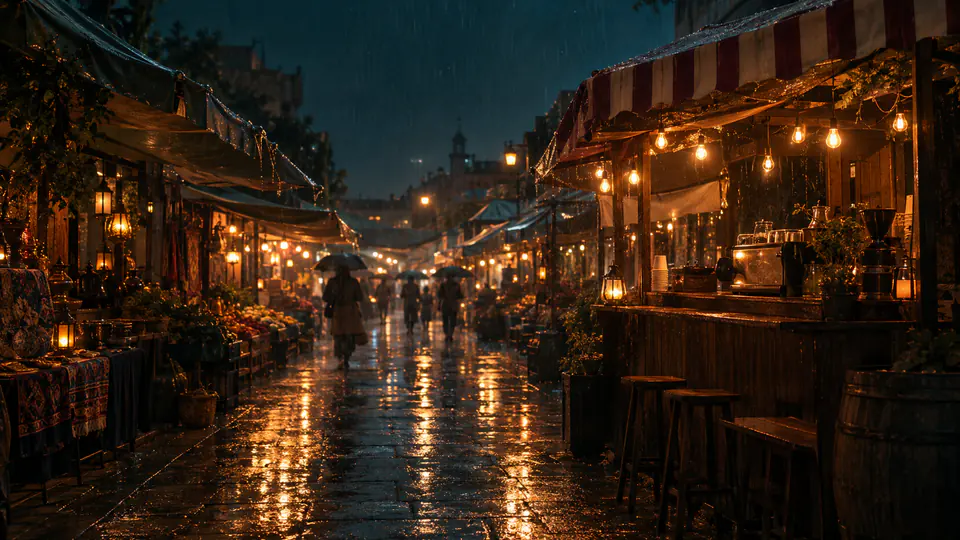
サンプルプロジェクトナイトマーケット:9ショットで構成された30秒のスポット。各キーフレームはGPT Image 2で作成し、動画モデルでアニメーション化しました。ボイス、効果音、音楽は組織自身のプロバイダーの音声モデルで作成しています。

すべてのプランで、アドオンなし。モデル支出への上乗せは0%。

意思決定モデル

意思決定モデルは型付きの質問に確率付きで答えます。INFROは各回答をアクションに変えます:モデル、ブロック、承認、ラベル。

8の意思決定モデルを、1つのAPIでいずれも自社のプロバイダーアカウントで。
POST/v1/chat/completionsルート分類器

3つのプロンプトがルートに届きます。それぞれについて、意思決定モデルはリクエストに必要な推論の量という選択式の質問に、small、medium、largeの確率付きで答えます。INFROのルートルールが最も可能性の高い分類に対応するモデルへリクエストを送り、レスポンスのX-INFRO-Route-Classヘッダーに分類名が示されます。 ここではOpenAIのGPT-6 Luna (Decisions)が回答しています。

  • 自社のプロバイダーアカウントすべての意思決定は自社の接続で実行され、プロバイダーから請求されます。
  • 予算の範囲内で呼び出し前に、キーの範囲と支出上限に照らして確認。
  • 費用とともに記録各呼び出しはリクエストログの1行になります:モデル、回答、推定費用。

料金

すべてのプランに、ロール、予算、モデルポリシー。年間払いは約2か月分少ない金額になります。

  • Developer

    最初のAI機能を本番に。プロバイダーが失敗したときのフォールバック付き。

    $35/ 月

    ゲートウェイリクエスト
    100k / 月
    シート
    1
  • Startup

    モデルの請求額が人員より速く増えているAIスタートアップ向け。

    $79/ 月

    ゲートウェイリクエスト
    500k / 月
    シート
    3
  • Team

    顧客ごと、機能ごと、キーごとのコスト。自社プロダクトの価格をそれに基づいて決めるチーム向け。

    $199/ 月

    ゲートウェイリクエスト
    2M / 月
    シート
    10
  • Business

    OpenAIとAnthropicが報告するコストを、お客様自身のログと照合。

    $599/ 月

    ゲートウェイリクエスト
    10M / 月
    シート
    無制限

Enterprise

調達、セキュリティレビュー、独自の条件を持つ組織向け。

個別の料金

四半期ごと、または年1回の請求書払い。 モデル利用料への上乗せは0%です。

SSOとSCIMを含むBusinessのすべてに加えて

  • セルフホストまたはハイブリッド: お客様自身のクラウド、またはホスト型コンソールと組み合わせたハイブリッドで。
  • 契約上のSLA: 契約で定める可用性と、その救済措置。
  • 専任エンジニア: 共有チャンネルと、合意したインシデント対応時間。
  • リクエスト量のカスタマイズ: Businessに含まれる月10Mを超える分は、ご相談のうえ決定します。
  • 365日間の履歴: リクエスト履歴は最大365日間。Businessは90日間です。
  • お客様のMSAとDPA: お客様の契約書面のレビューと、セキュリティ質問票への書面での回答。

14日間のトライアル · カードが必要 · 14日目までにキャンセルすれば請求されません · モデル利用料への上乗せは0%です。

よくある質問

INFROとは、具体的に何ですか?

INFRO は AIゲートウェイであり、コントロールプレーンです。アプリケーションと、すでに支払っている OpenAI、Anthropic、Google などの AI プロバイダーとの間に置く 1 つの API です。自社のプロバイダーアカウントを接続し、契約と料金はそのまま維持します。INFRO は各リクエストをルーティングし、プロバイダーがエラーを返せばフェイルオーバーし、呼び出しの前に予算を確認し、すべてのリクエストのレイテンシーと推定費用を記録し、キー・モデル・データにポリシーを適用します。エンジニアリングチームはテキスト、画像、動画、音声を 1 つの統合で扱うために、財務チームはチーム・プロジェクト・顧客ごとの支出を把握するために、プラットフォームとセキュリティのチームはプロバイダーキーとモデルアクセスを一元管理するために使います。モデルの利用料はプロバイダーがお客様の料金で直接請求し、INFRO はソフトウェアの月額サブスクリプションを請求します。モデル支出への上乗せは 0% です。

OpenAIやAnthropicを直接呼び出すのではなく、INFROを使う理由は?

1つのベンダーの1つのモデルだけを使っていて、その費用を誰も気にしていないなら、直接呼び出すほうがよいでしょう。それは本当の答えであり、評価の時間を無駄にさせるよりも、そうお伝えしたいと考えています。INFROが役に立つのは、次のいずれかに当てはまるときです。複数のベンダーの複数のモデルを使っている、プロバイダーの障害でプロダクトが止まったことがある、どの顧客や機能がいくら使っているのかを問われ始めた、プロバイダーキーが複数の場所に置かれるようになった。呼び出すプロバイダーもアカウントも同じままで、それらの間の統合、フェイルオーバー、費用の集計を自分で抱える必要がなくなります。

トライアルはどのように始まりますか?

dash.infro.io でアカウントを作成し、メールアドレスを確認します。組織を作成し、プランを選び、チェックアウトでカードを登録すると、チェックアウトの完了時に14日間のトライアルが始まります。14日目の終わりに、選択したプランの料金が自動で請求されます。14日目より前にキャンセルすれば請求されません。その間もモデル利用料は、引き続きプロバイダーからお客様に直接請求されます。

TypeSafeのJevをINFRO経由で実行できますか?

はい。INFROはTypeSafeのPOST /v1/systemoneを、TypeSafeのリクエストボディとモデル名で提供するので、新しいベースURLとINFROのゲートウェイキーを使えば、TypeSafeのSDKがそのままINFROで動きます。各判断はお客様自身のTypeSafeアカウントで実行され、TypeSafeからお客様に直接請求されます。TypeSafeを呼び出す前にINFROはキーと支出上限を確認し、呼び出し後はTypeSafeの回答を、回答したバージョンと推定費用とともに返し、リクエストを記録します。

INFRO自体に障害が起きたらどうなりますか?

依存先が1つ増えます。それがこの選択の正直なコストであり、考慮に入れるべきです。これを乗り切れるものにする仕組みが3つあります。ステータスページはゲートウェイとは別の、はるかにシンプルなデプロイで動いており、お客様自身のブラウザーからゲートウェイを確認します。テキストはOpenAIの形式に対応しているので、直接のプロバイダーキーとベースURLの切り替えを設定に残しておくことは、2行で済む備えであり、私たちも積極的に推奨しています。そして、公開しているアップタイムSLAはありません。運用実績のないサービスが誠実にSLAを提示することはできないためです。エンタープライズ契約には契約上のSLAを盛り込めます。

後から利用をやめられますか?

はい。戻るときの移行も、導入時と同じ2行です。リクエストと利用の履歴は公開APIで取得するか、リクエストログとAnalyticsからCSVでダウンロードし、プランの照会可能な履歴期間を過ぎる前に自社のシステムに保存してください。定期的なエクスポートやメールでのエクスポートはありません。

自社データはどのように扱われますか?学習に使われますか?

お客様のプロンプト、入力、出力を学習に使うことはなく、販売することもありません。利用メタデータは、プラットフォームの計測、費用の見積もり、ガバナンスに使われます。プロンプトとレスポンスのログ記録(任意)は既定でオフで、プランの範囲に限られます。配信に必要なジョブの記録と生成されたメディアは別に扱われます。AIプロバイダーによるデータの利用と保持の設定は、引き続きお客様とプロバイダーとの契約に従います。

さらに23件の回答

自社のプロバイダーアカウントで始めるか、まず当社チームと製品をご覧ください。