Connectez les comptes fournisseurs que vous détenez déjà. Vos applications appellent une seule API ; chaque requête s'exécute avec vos identifiants et est facturée par votre fournisseur.
Client typé pour le chat, les images, la vidéo et l'audio, avec routage, replis, métadonnées et coût estimé comme véritables arguments. Zéro dépendance, construit sur fetch.
Une seule surface, proposée comme client synchrone et asynchrone sur la même implémentation, de sorte qu'une complétion en streaming se comporte de façon identique dans les deux. Une dépendance, httpx.
La surface multimodale et le coût par requête au même endroit dans une application Flutter, au lieu d'un JSON écrit à la main dans un widget. Une dépendance, package:http.
Récupère le rapport de coûts d'OpenAI ou d'Anthropic, le compare à un export d'usage que vous avez déjà, et affiche l'écart par jour. Pas de compte INFRO, pas d'inscription, pas de fichier de configuration.
Exécutez-la sur votre propre compte fournisseur, ou via une clé de passerelle et sa politique. Voyez qui l'a servie, combien de temps cela a pris, ce que votre fournisseur facturera et la trace complète, puis copiez-la en cURL, Python ou TypeScript.
Une requête avec la fonctionnalité support-triage atteint la route nommée support. Sa première règle, long-prompts, envoie les prompts estimés à plus de 32 000 tokens d'entrée vers une connexion Vertex AI et ne correspond pas. La deuxième, support-triage, correspond et envoie la requête vers une connexion Anthropic, puis une connexion AWS Bedrock. Anthropic répond 429, la règle d'échec de la route pour rate_limit indique failover, et la connexion Bedrock la sert : la réponse nomme la route, la position dans la chaîne standby_a et le fournisseur.
POST/v1/chat/completionsRègles de route et basculement
Requête
Où en est le remboursement de la commande 4821 ?
feature "support-triage"input_tokens ≈ 1,900
Route supportrègles, dans l'ordre
long-promptsif input_tokens gt 32000 → vertex-prodne correspond pas
Cinq requêtes passent par l'API unique de INFRO : du texte vers Anthropic, une image vers OpenAI en résolution 2K et au format 16:9, une vidéo vers Runway en 1080p, la même vidéo en 720p, et de la voix vers ElevenLabs en mp3. INFRO vérifie chaque réglage par rapport à ce que le modèle accepte chez ce fournisseur avant de l'appeler. La vidéo en 1080p est refusée par INFRO et jamais envoyée à Runway, avec le message : Runway Gen-4 Turbo on Runway renders at 720p, not 1080p. En 720p, elle devient une tâche, signalée par un webhook signé à la fin.
Voyez ce qui s'est passé — et ce que cela a coûté.
Chaque requête est enregistrée avec sa route, la connexion qui l'a servie, chaque tentative, la latence, les tokens et une estimation de ce que votre fournisseur facturera — regroupés par projet, clé, modèle ou connexion.
Prévenu quand le coût ou le comportement change, même sans erreur.
INFRO compare le trafic de chaque jour avec ce qui est habituel pour lui.
Les changements silencieux deviennent des constats. Un nouveau snapshot, des réponses plus longues ou un cache de prompts perdu, chacun avec sa variation de coût hebdomadaire.
Anomalies et dérives de dépenses vous alertent par e-mail, Slack ou webhook.
Rapprochés chaque jour. Sur Business, le coût enregistré est comparé aux rapports de coûts de OpenAI et de Anthropic.
Deux vues s'affichent tour à tour. D'abord, les dépenses fournisseur estimées quotidiennes d'un projet tournent autour de leurs $410 habituels et sont projetées à $1,240 aujourd'hui ; trois constats suivent : un modèle servi par un nouveau snapshot avec son impact hebdomadaire estimé, les dépenses inhabituelles, et le rapport de coûts d'OpenAI qui diffère des estimations de INFRO. Ensuite, les dépenses du projet depuis le début du mois sont prévues à $5,820 pour un budget de $5,000 ; les constats sont la hausse des tokens de sortie par requête sur un modèle, la prévision au-delà du budget, et le rapport de coûts d'Anthropic qui diffère des estimations. Les constats de rapprochement sont marqués avec l'offre qui les inclut.
GET/v1/alertsConstats, aussi dans la console
Dépenses quotidiennes · projet support-assistantJournée habituelle $410Projection du jour $1,240
traffic.model_changedopenai/gpt-5.6-terra est servi par un nouveau snapshot du modèle : gpt-5.6-terra-2026-10-02Avant gpt-5.6-terra-2026-08-14+$212.40Impact hebdomadaire estimé
spend.anomalyDépenses inhabituelles : le projet support-assistant se dirige vers $1,240 aujourd'huiJournée habituelle $410$1,240Projection du jour
cost.driftBusinessLes estimations de coûts pour openai sont 8.4% en dessous de ce que le fournisseur a déclaréSource API de coûts OpenAI6 sur 7Jours en dérive
Depuis le début du mois · projet support-assistantBudget $5,000Prévision $5,820
traffic.regressionLes tokens de sortie par requête ont augmenté sur openai/gpt-5.6-terraTokens de sortie par requête 412 → 655+$96.10Impact hebdomadaire estimé
spend.forecast_over_budgetPrévision au-delà du budget : le projet support-assistant se dirige vers $5,820 sur $5,000Budget $5,000 par mois$5,820Prévision
cost.driftBusinessLes estimations de coûts pour anthropic sont 6.1% au-dessus de ce que le fournisseur a déclaréSource Rapport de coûts Anthropic5 sur 7Jours en dérive
Deux clés de passerelle et leur politique. La clé de production appartient au projet support-assistant, peut utiliser Anthropic et AWS Bedrock depuis une plage IP, et le projet autorise un modèle sous un budget bloquant. Ses requêtes sont tranchées une à une avant tout appel à un fournisseur : un modèle autorisé est servi par la connexion Anthropic, un modèle hors de la liste d'autorisation est refusé 403 model_not_allowed, une requête depuis une autre adresse est refusée 403 ip_not_allowed, et une requête au-delà du budget du projet est refusée 402 budget_exceeded avec le code project_budget. La clé de préproduction ne peut pas atteindre une connexion limitée à la production et est refusée 503 connection_out_of_scope ; un modèle servi par une connexion de préproduction passe.
POST/v1/chat/completionsVérifié avant le fournisseur
support-prodprojet support-assistantenvironnementproductionfournisseursanthropic, aws-bedrockPlages IP10.20.0.0/16modèlesanthropic/claude-sonnet-5.5budget$5,000 par mois, bloquant
batch-stagingorganisationenvironnementstagingfournisseurstous les fournisseursPlages IPtout
Des requêtes tranchées avant tout appel à un fournisseur
Un plafond pour chaque personne, et pour chacun de vos clients.
Plafonnez les dépenses fournisseur estimées de chaque membre pour le mois, et choisissez si l'atteinte du plafond alerte ou bloque.
Chaque clé qu'ils créent compte dans un seul plafond.
Bloquer ou alerter, réglé par personne.
La politique la plus stricte l'emporte entre organisation, projet et clé.
Budgets d'équipe
Ce mois-ci · dépenses fournisseur estimées
Dépenses de l'équipe
$245 sur $450
Restant
$205
Membres de l'équipe et leurs plafonds mensuels sur les dépenses fournisseur estimées ce mois-ci
Personne
Plafond mensuelUn plafond mensuel sur les dépenses fournisseur estimées, sur toutes les clés de passerelle créées par ce membre. Les politiques d'organisation, de projet et de clé peuvent aussi s'appliquer, et la plus stricte l'emporte.
Ce mois-ci
Restant
Maya ChenMembre · 2 clés
Plafond mensuelBloque au plafond
Ce mois-ci$120 sur $20060%
Restant$80
Omar AliMembre · 1 clé
Plafond mensuelBloque au plafond
Ce mois-ci$80 sur $10080%Proche du plafond
Restant$20
Lena BrooksAdministrateur · 1 clé
Plafond mensuelAlerte uniquement
Ce mois-ci$45 sur $15030%
Restant$105
Vos clients
Plafonnez ce que chacun de vos propres clients peut dépenser par jour, semaine ou mois. Envoyez son identifiant avec la requête ; quand il atteint le plafond, la passerelle répond 402 avec l'heure de réinitialisation, pour que votre application puisse le lui dire. À partir de l'offre Team.
Trois de vos clients, chacun avec un plafond quotidien de 2 dollars de dépenses fournisseur estimées. Leurs requêtes sont servies et le compteur de chaque client se remplit. Une requête qui ferait dépasser le plafond à cus_4f2a est refusée avec un 402 avant d'atteindre votre fournisseur, et la réponse indique quand le plafond est réinitialisé : 00:00 UTC. À minuit UTC, tous les plafonds quotidiens sont réinitialisés.
cus_7a2c+$0.60$0.00$0.60
cus_91be+$0.40$0.00$0.40
cus_4f2a+$0.90+$0.80$0.00$0.90$1.70
Sous le plafond : servie402cus_4f2aPlafond atteint · réinitialisé à 00:00 UTC00:00 UTC · tous les plafonds quotidiens sont réinitialisés
Touslesmodèlesquevouspayez,dansunseulstudio.
Images, vidéo et son chez les fournisseurs que vous payez déjà, du premier prompt au montage que votre logiciel ouvre.
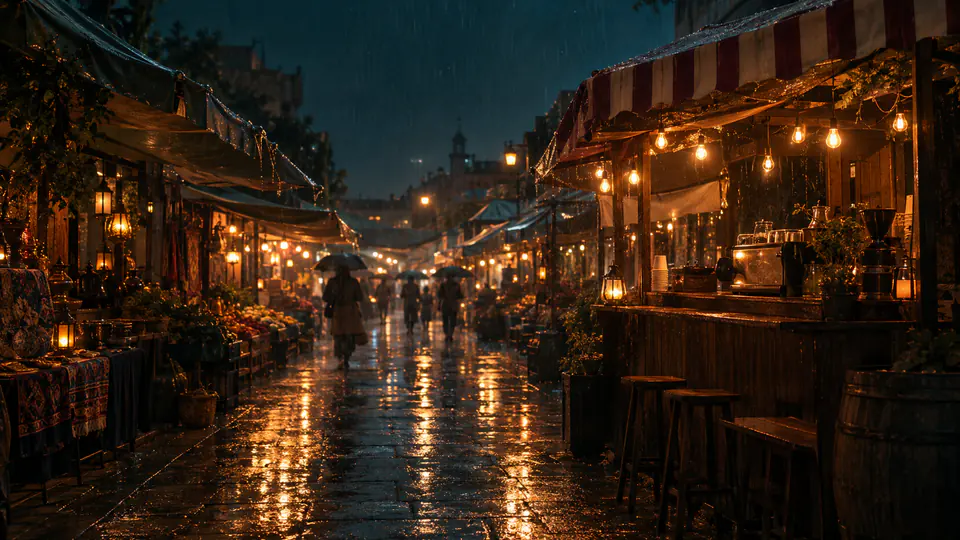
1ALe marché sous la pluieArrivée1BMara sous l'auventArrivée1CLanternes, gros planArrivée2ALa tasseLe stand2BKen verseLe stand2CPluie sur la vitreLe stand3ASous un même parapluieEnsemble3BLa ruelle en montéeEnsemble3CAube, carton finalEnsemble
Un projet d'exemple, Marché de nuit : un spot de 30 secondes en 9 plans. Chaque image clé a été produite avec GPT Image 2 puis animée sur un modèle vidéo, avec la voix, les effets et la musique sur les modèles audio des propres fournisseurs de l'organisation.
3 en coursest. $2.23 en cours
Mara et Ken partagent un parapluie dans l'allée mouillée du…GPT Image 2 · OpenAI · env. $1.84
piano lo-fi chaleureux, pluie légère, plein d'espoirEleven Music · ElevenLabs · env. $0.07
Agrandissement de vidéoTopaz Video Upscale · Replicate · env. $0.32
2B Répliqueenv. <$0.01
Ken“Dernière tasse de la nuit.”ElevenLabs V4 · ElevenLabs
1B Mara sous l'auvent4 prises
Kling O3fal · 4 s · $0.45 Conservée
Veo 3.1Google · 4 s · $1.60
Seedance 2.0Replicate · 4 s · $0.60
Runway Gen-4.5Runway · 4 s · $0.48
Kling O3 conservé
ImageVoixEffetsMusique
0s51015202530
MaraKenElevenLabs V4
ElevenLabs Sound Effects v2
Eleven Music · piano lo-fi chaleureux, pluie légère, plein d'espoir
Les modèles de décision répondent à des questions typées avec des probabilités. INFRO transforme chaque réponse en action : un modèle, un blocage, une validation, une étiquette.
8modèles de décision, une seule APIChacun sur votre propre compte fournisseur.
Classer chaque prompt d'une route et envoyer chaque classe vers son propre modèle grâce aux règles de route.
POST/v1/chat/completionsClassificateur de routemodelopenai/gpt-6-luna-decisions
Trois prompts arrivent sur une route. Pour chacun, le modèle de décision répond à une question à choix, de combien de raisonnement la requête a besoin, avec une probabilité pour small, medium et large. Les règles de route d'INFRO envoient la requête vers le modèle de la classe la plus probable, et la réponse nomme la classe dans l'en-tête X-INFRO-Route-Class. Réponse ici de GPT-6 Luna (Decisions), de OpenAI.
Prompt
Quel est votre délai de remboursement ?
GPT-6 LunaOpenAIchoice
De combien de raisonnement cette requête a-t-elle besoin ?
small0.86Gemini 3.8 Flash
medium0.11Claude Sonnet 5.5
large0.03Claude Opus 5.5
En attente de la réponse200X-INFRO-Route-Classsmall; confidence=0.79; source=modelmodelgoogle/gemini-3.8-flash
01Vos comptes fournisseursChaque décision s'exécute sur votre propre connexion, facturée par votre fournisseur.
02Dans vos budgetsVérifié par rapport au périmètre de la clé et aux limites de dépenses avant l'appel.
03Enregistré avec son coûtChaque appel est une ligne du journal des requêtes : modèle, réponse, coût estimé.
INFRO est une passerelle IA et un plan de contrôle : une seule API entre vos applications et les fournisseurs d'IA que vous payez déjà, comme OpenAI, Anthropic et Google. Vous connectez vos propres comptes fournisseurs et conservez vos contrats et vos tarifs ; INFRO route chaque requête, bascule quand un fournisseur renvoie une erreur, vérifie les budgets avant l'appel, enregistre la latence et le coût estimé de chaque requête et applique des règles sur les clés, les modèles et les données. Les équipes d'ingénierie l'utilisent pour une seule intégration couvrant texte, image, vidéo et audio ; les équipes finance pour les dépenses par équipe, projet et client ; les équipes plateforme et sécurité pour le contrôle centralisé des clés fournisseurs et de l'accès aux modèles. Vos fournisseurs vous facturent directement l'usage des modèles, à vos tarifs ; INFRO facture un abonnement mensuel pour le logiciel, avec 0 % de majoration sur les dépenses de modèles.
Pourquoi utiliser INFRO plutôt que d'appeler OpenAI ou Anthropic directement ?
Si vous utilisez un seul modèle d'un seul éditeur et que personne ne s'est demandé ce qu'il coûte, vous devriez sans doute passer en direct — c'est une vraie réponse, et nous préférons la donner plutôt que de vous faire perdre votre évaluation. INFRO se justifie dès que l'un de ces points est vrai : vous utilisez plusieurs modèles de plusieurs éditeurs, un incident fournisseur a mis votre produit hors service, quelqu'un a commencé à demander quel client ou quelle fonctionnalité dépense quoi, ou des clés fournisseur ont commencé à apparaître à plusieurs endroits. Vous appelez toujours les mêmes fournisseurs sur les mêmes comptes ; vous cessez simplement de porter l'intégration, le basculement et la comptabilité entre eux.
Comment démarre l'essai ?
Créez un compte sur dash.infro.io et vérifiez votre adresse e-mail. Vous créez votre organisation, choisissez une offre et ajoutez une carte au paiement, et votre essai de 14 jours commence une fois ce paiement finalisé. À la fin du jour 14, l'offre choisie est prélevée automatiquement — résiliez avant le jour 14 et vous ne serez pas débité. Vos fournisseurs continuent de vous facturer directement l'usage des modèles pendant toute la période.
Puis-je utiliser Jev de TypeSafe via INFRO ?
Oui. INFRO sert POST /v1/systemone de TypeSafe avec le corps de requête et les noms de modèles de TypeSafe, de sorte que le SDK de TypeSafe fonctionne avec INFRO grâce à une nouvelle URL de base et une clé de passerelle INFRO. Chaque décision s'exécute sur votre propre compte TypeSafe et TypeSafe vous la facture directement. Avant l'appel à TypeSafe, INFRO vérifie la clé et toute limite de dépenses ; ensuite, il renvoie les réponses de TypeSafe avec la version qui a répondu et un coût estimé, et enregistre la requête.
Que se passe-t-il si INFRO tombe en panne ?
Nous devenons une dépendance de plus — c'est le coût honnête de ce choix, et vous devez en tenir compte. Trois éléments le rendent supportable. La page d'état tourne sur un déploiement distinct et bien plus simple que la passerelle, et vérifie la passerelle depuis votre propre navigateur. Le texte parle le format OpenAI : garder une clé fournisseur directe et un interrupteur d'URL de base dans votre configuration est un plan de secours de deux lignes que nous recommandons activement. Et il n'y a pas de SLA de disponibilité publié, car un service sans historique d'exploitation ne peut pas honnêtement en proposer un ; un contrat entreprise peut en comporter un contractuel.
Puis-je partir plus tard ?
Oui, et le retour en arrière tient dans les deux mêmes lignes qui vous ont fait venir. Récupérez l'historique des requêtes et de l'usage via les API publiques, ou téléchargez-le en CSV depuis le journal des requêtes et Analytics, et conservez-le dans vos propres systèmes avant qu'il ne sorte de la fenêtre d'historique consultable de votre offre. Il n'y a pas d'exports planifiés ni envoyés par e-mail.
Comment les données de notre entreprise sont-elles traitées, et servent-elles à l'entraînement ?
Nous n'entraînons jamais de modèle sur vos prompts, entrées ou sorties, et nous ne les vendons jamais. Les métadonnées d'usage servent au comptage de la plateforme, aux estimations de coûts et à la gouvernance. La journalisation facultative des prompts et des réponses est désactivée par défaut et limitée par votre offre. Les enregistrements de tâches et les médias générés nécessaires à la livraison sont séparés. Les paramètres d'usage et de conservation des données de vos fournisseurs d'IA restent régis par vos contrats avec eux.