Collega gli account dei provider che hai già. Le tue app chiamano un'unica API; ogni richiesta gira sulle tue credenziali ed è fatturata dal tuo provider.
Client tipizzato per chat, immagini, video e audio, con routing, fallback, metadati e costo stimato come veri argomenti. Zero dipendenze, costruito su fetch.
Una sola superficie, offerta come client sincrono e asincrono sulla stessa implementazione, così un completamento in streaming si comporta in modo identico in entrambi. Una dipendenza, httpx.
La superficie multimodale e la cifra del costo per richiesta in un unico posto dentro un'app Flutter, invece di JSON scritto a mano in un widget. Una dipendenza, package:http.
Scarica il report dei costi di OpenAI o di Anthropic, lo confronta con un'esportazione di utilizzo che già hai e stampa lo scostamento giornaliero. Nessun account INFRO, nessuna registrazione, nessun file di configurazione.
Eseguila sul tuo account del provider, o tramite una chiave del gateway e la sua policy. Vedi chi l'ha servita, quanto ci ha messo, cosa ti fatturerà il provider e la trace completa, poi copiala come cURL, Python o TypeScript.
Una richiesta con la funzionalità support-triage raggiunge la route chiamata support. La sua prima regola, long-prompts, invia i prompt stimati oltre 32.000 token di input a una connessione Vertex AI e non corrisponde. La seconda, support-triage, corrisponde e invia la richiesta a una connessione Anthropic, poi a una connessione AWS Bedrock. Anthropic risponde 429, la regola di errore della route per rate_limit dice failover, e la connessione Bedrock la serve: la risposta indica la route, la posizione nella catena standby_a e il provider.
POST/v1/chat/completionsRegole delle route e failover
Cinque richieste passano dall'unica API di INFRO: testo ad Anthropic, un'immagine a OpenAI con risoluzione 2K e proporzioni 16:9, un video a Runway a 1080p, lo stesso video a 720p e una sintesi vocale a ElevenLabs in mp3. INFRO controlla ogni impostazione rispetto a ciò che il modello accetta su quel provider prima di chiamarlo. Il video a 1080p viene rifiutato da INFRO e mai inviato a Runway, con il messaggio: Runway Gen-4 Turbo on Runway renders at 720p, not 1080p. A 720p diventa un job, segnalato da un webhook firmato quando termina.
/v1 · un'unica APIImpostazioni controllate prima della chiamata
Ogni richiesta viene registrata con la route, la connessione che l'ha servita, ogni tentativo, latenza, token e una stima di quanto ti fatturerà il provider, raggruppata per progetto, chiave, modello o connessione.
Avvisato quando cambiano costi o comportamento, anche senza un errore.
INFRO confronta il traffico di ogni giorno con ciò che è abituale per esso.
Le variazioni silenziose diventano rilevazioni. Un nuovo snapshot, risposte più lunghe o una cache dei prompt persa, ciascuno con la sua variazione di costo settimanale.
Anomalie e derive della spesa ti avvisano via email, Slack o webhook.
Riconciliato ogni giorno. Su Business, il costo registrato viene confrontato con i report dei costi di OpenAI e Anthropic.
Si alternano due viste. Nella prima, la spesa giornaliera stimata verso i provider di un progetto è vicina ai soliti $410 e la proiezione per oggi è di $1,240; seguono tre rilevazioni: un modello a cui risponde un nuovo snapshot, con il suo impatto settimanale stimato, la spesa insolita, e il report dei costi di OpenAI che differisce dalle stime di INFRO. Nella seconda, la spesa del progetto dall'inizio del mese ha una previsione di $5,820 rispetto a un budget di $5,000; le rilevazioni sono l'aumento dei token di output per richiesta su un modello, la previsione oltre il budget e il report dei costi di Anthropic che differisce dalle stime. Le rilevazioni di riconciliazione sono contrassegnate con il piano che le include.
GET/v1/alertsRilevazioni, anche nella console
Spesa giornaliera · progetto support-assistantGiorno abituale $410Proiezione di oggi $1,240
traffic.model_changedA openai/gpt-5.6-terra risponde un nuovo snapshot del modello: gpt-5.6-terra-2026-10-02Prima gpt-5.6-terra-2026-08-14+$212.40Impatto settimanale stimato
spend.anomalySpesa insolita: il progetto support-assistant si avvia verso $1,240 oggiGiorno abituale $410$1,240Proiezione di oggi
cost.driftBusinessLe stime dei costi per openai sono 8.4% sotto quanto riportato dal providerFonte API dei costi di OpenAI6 di 7Giorni in deriva
Dall'inizio del mese · progetto support-assistantBudget $5,000Previsione $5,820
traffic.regressionI token di output per richiesta sono aumentati su openai/gpt-5.6-terraToken di output per richiesta 412 → 655+$96.10Impatto settimanale stimato
spend.forecast_over_budgetPrevisione oltre il budget: il progetto support-assistant si avvia verso $5,820 su $5,000Budget $5,000 al mese$5,820Previsione
cost.driftBusinessLe stime dei costi per anthropic sono 6.1% sopra quanto riportato dal providerFonte Report dei costi di Anthropic5 di 7Giorni in deriva
Due chiavi del gateway e la loro policy. La chiave di produzione appartiene al progetto support-assistant, può usare Anthropic e AWS Bedrock da un intervallo IP, e il progetto consente un modello sotto un budget bloccante. Le sue richieste vengono decise una alla volta prima di chiamare qualsiasi provider: un modello consentito viene servito dalla connessione Anthropic, un modello fuori dalla allowlist viene rifiutato con 403 model_not_allowed, una richiesta da un altro indirizzo viene rifiutata con 403 ip_not_allowed, e una richiesta oltre il budget del progetto viene rifiutata con 402 budget_exceeded con codice project_budget. La chiave di staging non può raggiungere una connessione limitata alla produzione e viene rifiutata con 503 connection_out_of_scope; un modello servito da una connessione di staging passa.
POST/v1/chat/completionsControllato prima del provider
support-prodprogetto support-assistantambienteproductionprovideranthropic, aws-bedrockIntervalli IP10.20.0.0/16modellianthropic/claude-sonnet-5.5budget$5,000 al mese, blocca
Un tetto per ogni persona, e per ognuno dei tuoi clienti.
Imposta un tetto alla spesa stimata verso i provider di ogni membro per il mese, e scegli se raggiungerlo genera un avviso o un blocco.
Ogni chiave che crea conta verso un unico tetto.
Blocca o avvisa, impostato per persona.
Vince la policy più restrittiva tra organizzazione, progetto e chiave.
Budget del team
Questo mese · spesa stimata verso i provider
Spesa del team
$245 su $450
Rimanente
$205
Membri del team e i loro tetti mensili sulla spesa stimata verso i provider di questo mese
Persona
Tetto mensileUn tetto mensile sulla spesa stimata verso i provider, su tutte le chiavi del gateway create da questo membro. Possono applicarsi anche policy di organizzazione, progetto e chiave, e vince la più restrittiva.
Questo mese
Rimanente
Maya ChenMembro · 2 chiavi
Tetto mensileBlocca al tetto
Questo mese$120 su $20060%
Rimanente$80
Omar AliMembro · 1 chiave
Tetto mensileBlocca al tetto
Questo mese$80 su $10080%Vicino al tetto
Rimanente$20
Lena BrooksAmministratore · 1 chiave
Tetto mensileSolo avviso
Questo mese$45 su $15030%
Rimanente$105
I tuoi clienti
Imposta un tetto a quanto ognuno dei tuoi clienti può spendere al giorno, alla settimana o al mese. Invia il suo id con la richiesta; quando raggiunge il tetto, il gateway risponde 402 con l'ora in cui si azzera, così la tua app può dirglielo. Dal piano Team.
Tre dei tuoi clienti, ciascuno con un tetto giornaliero di 2 dollari di spesa stimata verso i provider. Le loro richieste vengono servite e il contatore di ogni cliente si riempie. Una richiesta che porterebbe cus_4f2a oltre il tetto viene rifiutata con 402 prima di raggiungere il tuo provider, e la risposta indica quando il tetto si azzera: 00:00 UTC. A mezzanotte UTC ogni tetto giornaliero si azzera.
cus_7a2c+$0.60$0.00$0.60
cus_91be+$0.40$0.00$0.40
cus_4f2a+$0.90+$0.80$0.00$0.90$1.70
Sotto il tetto: servita402cus_4f2aTetto raggiunto · si azzera alle 00:00 UTC00:00 UTC · ogni tetto giornaliero si azzera
Ognimodellochepaghi,inunsolostudio.
Immagini, video e suono sui provider che già paghi, dal primo prompt al montaggio che il tuo editor apre.
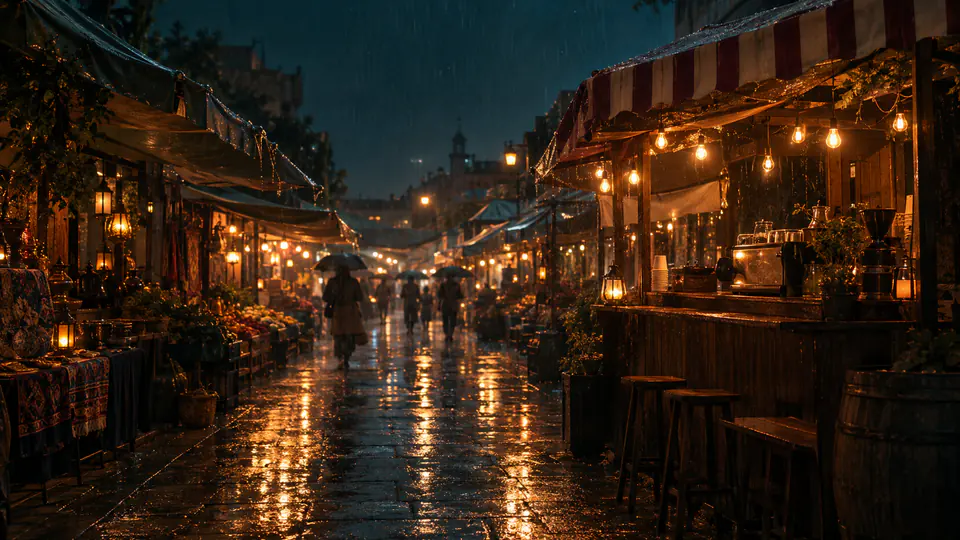
1AIl mercato sotto la pioggiaArrivo1BMara sotto la tendaArrivo1CLanterne, primo pianoArrivo2ALa tazzaIl chiosco2BKen versaIl chiosco2CPioggia sulla finestraIl chiosco3ASotto un solo ombrelloInsieme3BIl vicolo in salitaInsieme3CAlba, scheda finaleInsieme
Un progetto di esempio, Mercato notturno: uno spot di 30 secondi in 9 inquadrature. Ogni keyframe è stato creato con GPT Image 2 e animato su un modello video, con voce, effetti e musica sui modelli audio dei provider dell'organizzazione.
3 in esecuzionestima $2.23 in corso
Mara e Ken condividono un ombrello lungo la corsia bagnata …GPT Image 2 · OpenAI · stima $1.84
I modelli decisionali rispondono a domande tipizzate con probabilità. INFRO trasforma ogni risposta in un'azione: un modello, un blocco, un'approvazione, un'etichetta.
8modelli decisionali, un'unica APIOgnuno sul tuo account del provider.
Classifica ogni prompt su una route e invia ogni classe al proprio modello con le regole della route.
POST/v1/chat/completionsClassificatore della routemodelopenai/gpt-6-luna-decisions
Tre prompt arrivano su una route. Per ciascuno il modello decisionale risponde a una domanda a scelta, quanto ragionamento richiede la richiesta, con una probabilità per small, medium e large. Le regole della route di INFRO inviano la richiesta al modello della classe più probabile, e la risposta indica la classe nell'header X-INFRO-Route-Class. Qui risponde GPT-6 Luna (Decisions) di OpenAI.
Prompt
Qual è la vostra finestra per i rimborsi?
GPT-6 LunaOpenAIchoice
Quanto ragionamento richiede questa richiesta?
small0.86Gemini 3.8 Flash
medium0.11Claude Sonnet 5.5
large0.03Claude Opus 5.5
In attesa della risposta200X-INFRO-Route-Classsmall; confidence=0.79; source=modelmodelgoogle/gemini-3.8-flash
01I tuoi account dei providerOgni decisione gira sulla tua connessione, fatturata dal tuo provider.
02Dentro i tuoi budgetControllato rispetto all'ambito della chiave e ai limiti di spesa prima della chiamata.
03Registrato con il suo costoOgni chiamata è una riga nel log delle richieste: modello, risposta, costo stimato.
INFRO è un gateway IA e un piano di controllo: un'unica API tra le tue applicazioni e i provider di IA che già paghi, come OpenAI, Anthropic e Google. Colleghi i tuoi account dei provider e mantieni contratti e prezzi; INFRO instrada ogni richiesta, esegue il failover quando un provider restituisce un errore, verifica i budget prima della chiamata, registra la latenza e il costo stimato di ogni richiesta e applica policy su chiavi, modelli e dati. I team di engineering lo usano per un'unica integrazione su testo, immagini, video e audio; i team finance per la spesa per team, progetto e cliente; i team di piattaforma e sicurezza per il controllo centralizzato delle chiavi dei provider e dell'accesso ai modelli. I tuoi provider ti fatturano direttamente l'uso dei modelli, ai tuoi prezzi; INFRO addebita un abbonamento mensile per il software, con 0% di ricarico sulla spesa per i modelli.
Perché usare INFRO invece di chiamare direttamente OpenAI o Anthropic?
Se usi un solo modello di un solo vendor e nessuno ha chiesto quanto costa, probabilmente dovresti andare diretto: è una risposta reale e preferiamo darla piuttosto che farti perdere tempo nella valutazione. INFRO si guadagna il suo posto quando almeno una di queste condizioni è vera: usi diversi modelli di diversi vendor, un incidente di un provider ha bloccato il tuo prodotto, qualcuno ha iniziato a chiedere quale cliente o funzionalità spende quanto, oppure le chiavi dei provider hanno iniziato a comparire in più di un posto. Continui a chiamare gli stessi provider sugli stessi account; smetti di gestire tu l'integrazione, il failover e la contabilità tra loro.
Come inizia la prova?
Crea un account su dash.infro.io e verifica il tuo indirizzo email. Crei la tua organizzazione, scegli un piano e aggiungi una carta al checkout, e la prova di 14 giorni inizia quando il checkout è completato. Alla fine del giorno 14 il piano selezionato viene addebitato automaticamente: annulla prima del giorno 14 e non ti verrà addebitato nulla. Per tutto il periodo i tuoi provider continuano a fatturarti direttamente l'uso dei modelli.
Posso usare Jev di TypeSafe tramite INFRO?
Sì. INFRO serve POST /v1/systemone di TypeSafe con il corpo di richiesta e i nomi dei modelli di TypeSafe, quindi l'SDK di TypeSafe funziona con INFRO con un nuovo URL di base e una chiave del gateway INFRO. Ogni decisione gira sul tuo account TypeSafe e TypeSafe te la fattura direttamente. Prima che TypeSafe venga chiamato, INFRO controlla la chiave e l'eventuale limite di spesa; dopo restituisce le risposte di TypeSafe con la versione che ha risposto e un costo stimato, e registra la richiesta.
Cosa succede se è INFRO stesso a guastarsi?
Diventiamo una dipendenza in più: è il costo onesto dello scambio, e dovresti tenerne conto. Tre cose lo rendono sostenibile. La pagina di stato gira su un deployment separato e molto più semplice del gateway e controlla il gateway dal tuo browser. Il testo usa la forma di OpenAI, quindi tenere una chiave diretta del provider e uno switch dell'URL di base nella tua configurazione è un piano di riserva di due righe che consigliamo attivamente. E non c'è uno SLA di uptime pubblicato, perché un servizio senza storico operativo non può offrirne onestamente uno; un accordo enterprise può includerne uno contrattuale.
Posso andarmene in seguito?
Sì, e la migrazione di ritorno richiede le stesse due righe che ti hanno portato qui. Recupera lo storico di richieste e utilizzo tramite le API pubbliche, oppure scaricalo in CSV dal log delle richieste e da Analytics, e conservalo nei tuoi sistemi prima che esca dalla finestra di storico consultabile del tuo piano. Non ci sono esportazioni pianificate o inviate per email.
Come vengono trattati i dati della nostra azienda, e li usate per l'addestramento?
Non usiamo mai i tuoi prompt, input o output per l'addestramento, e non li vendiamo mai. I metadati di utilizzo servono alla misurazione della piattaforma, alle stime dei costi e alla governance. Il logging facoltativo di prompt e risposte è disattivato per impostazione predefinita e limitato dal tuo piano. I record dei job e i contenuti multimediali generati necessari per la consegna sono separati. Le impostazioni di uso e conservazione dei dati dei tuoi provider IA restano regolate dai tuoi accordi con loro.